谷歌云服务器开通与轻量级云原生落地实操:Compute Engine内核性能压榨、CUD长约省钱方案与DevOps避坑白皮书
一、【老司机的避坑日记】一台开通就卡顿的云服务器背后的秘密——参数调优的人性化反思
在多年的云运维与技术支持生涯中,我见过太多刚接触 Google Cloud 的工程师犯下一个看似常识、实则代价高昂的错误。
上个月,一家知名跨境 SaaS 团队的运维负责人联系我们:“我们在控制台刚开通了几台 16 核 64G 的高配 Compute Engine 实例,按理说性能应该极为强劲,但为什么海外用户在进行高并发 WebSocket 通信与大文件并发下载时,网络吞吐始终卡在几十兆上不去?丢包率居高不下,服务器 CPU 利用率甚至不到 15%,这是不是谷歌云服务器在‘偷偷限速’?”
当我们远程登录进入其 Linux 系统底层后,真相令人哭笑不得:他们直接使用了社区未经任何调优的默认 Linux 镜像模板。系统的 TCP 拥塞控制算法依然停留在过时的 `cubic` 模式,TCP 读写缓冲区最大仅分配了 200KB,系统最大连接跟踪数(`nf_conntrack_max`)早已在突发流量下被瞬间打满,更糟糕的是,其磁盘类型误选为了吞吐极低的慢速标准机械盘(Standard Persistent Disk)!
云计算绝不是‘开通即最佳’的傻瓜玩具。一台未经科学调优的云服务器,其真实的硬件性能可能只能发挥出不到 30%;而经过我们深度内核定制与架构调优后的 Compute Engine 实例,能够在相同配置下扛住 3 倍以上的并发流量,同时网络延迟降低 60% 以上!
本文将手把手带您走一遍从谷歌云服务器开通、机型科学选型,到 Linux 内核参数极致压榨、高可用托管组部署以及企业级 FinOps 降本的完整实操闭环。
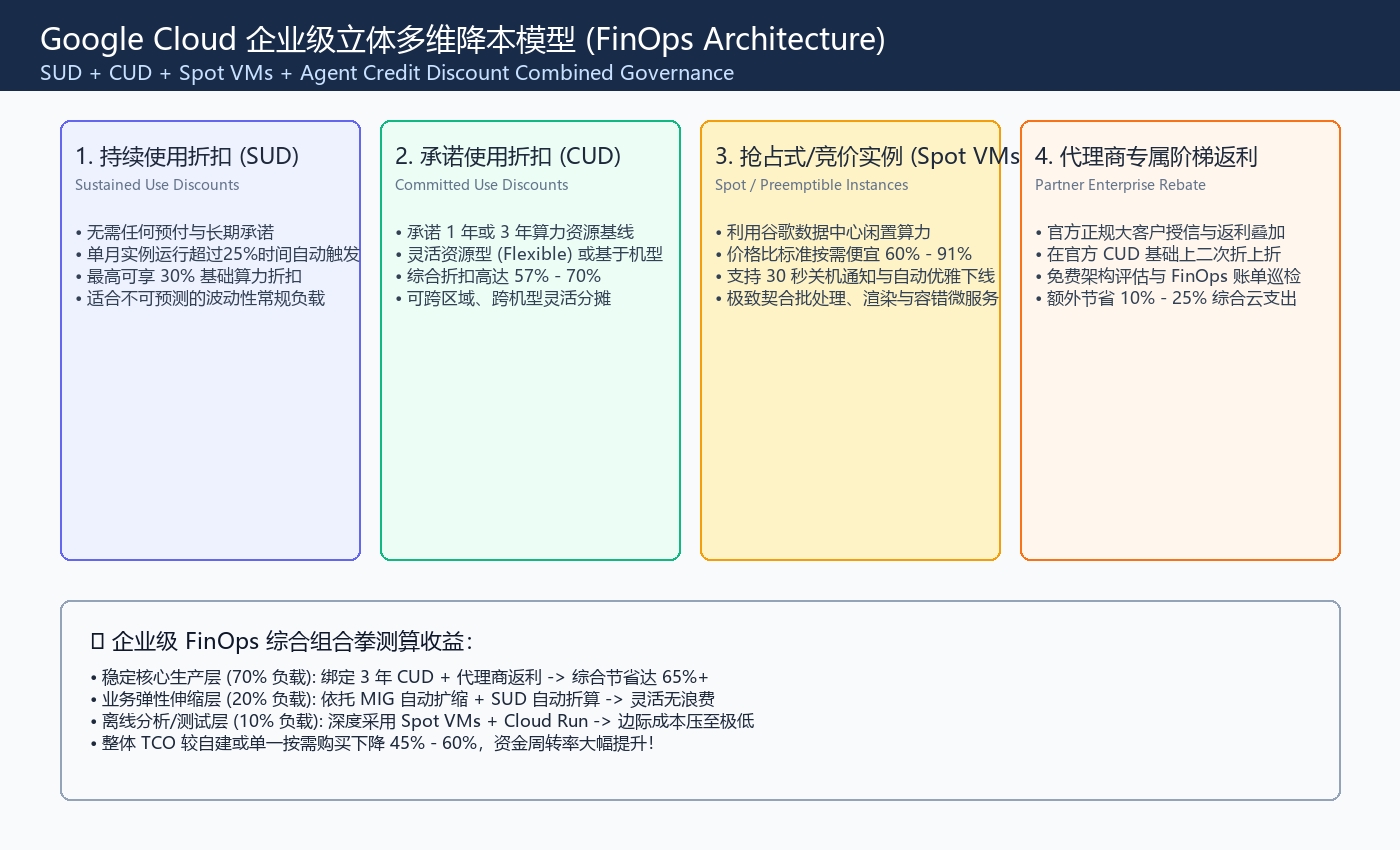
图 1:Compute Engine 实例族谱与轻量级应用选型决策矩阵
二、谷歌云服务器实例开通与精准选型指南:C3/C3D vs N2/N2D vs E2 及轻量级协同
在 Google Cloud 控制台创建虚拟机实例时,面对琳琅满目的机器类型(Machine Types),如何精准匹配业务负载,直接关系到系统性能与真金白银的账单开销。
1. 主流实例族谱与典型业务匹配法则
• C3 / C3D(计算优化型算力旗舰):搭载第四代英特尔至强可扩展处理器或 AMD EPYC Genoa 处理器,内置自研 IPU 硬件加速。适用于高性能计算(HPC)、广告实时竞价(RTB)、高频交易、MMORPG 游戏服主逻辑节点以及音视频转码渲染等重算力场景。
• N2 / N2D(通用平衡型企业主力):性价比与性能的完美平衡点,提供极度平稳的基准性能。特别支持【自定义机器类型(Custom Machine Type)】,允许架构师按需自由指定如 6 核心 19GB 内存这种非标准配比,避免为传统固定档位中的闲置内存多掏冤枉钱。适用于主流 Web 应用、中间件集群、ERP 后端与中型 MySQL/PostgreSQL 数据库。
• Tau T2D(横向扩展 Scale-Out 算力之王):基于 AMD EPYC 处理器深度定制,默认关闭 SMT 超线程,每一个 vCPU 均为完整的物理核心,单核性能极度强悍且单价亲民。非常适合微服务集群、无状态 Web 前端集群与容器化基础设施。
• E2(成本优先型轻量实例):利用谷歌动态算力调度技术,提供极低单价的共享算力。与传统突发机型(如某些云厂商的积分枯竭限速机制)不同,E2 没有复杂的 CPU 积分惩罚,即便在算力超分时也能提供稳定的基线输出,是构建开发测试环境、企业内部低并发办公后台及小型站点的降本利器。
2. 轻量级应用与 Serverless 容器的高效协同
对于很多只需运行轻量级 Python 脚本、Node.js API 网关或事件驱动型微服务的场景,完全无需单独开辟常驻虚拟机。通过将轻量级容器部署于【Cloud Run】,配合 VPC Access Connector 与内网 Compute Engine 共享后端 Redis/数据库,能够实现无访问时实例自动缩容至 0,来请求时毫秒级冷启动拉起,将轻量级负载的云端开销直接压缩至极限。
三、Linux 底层内核与网络协议栈终极压榨实录:生产级调优清单
开通 Compute Engine 实例后,建议运维团队在初始化镜像(Golden Image / Cloud-Init)中统一固化以下底层调优脚本,彻底释放硬件潜能。
1. 开启 Google BBR 拥塞控制算法
BBR 是 Google 针对跨国长肥网络(Long Fat Network)研发的革命性拥塞控制算法。与基于丢包驱动的传统 Cubic 算法相比,BBR 通过实时探测网络瓶颈带宽与往返时延(RTT),在网络出现轻微丢包时依然能维持最大带宽利用率。在跨境传输场景下,开启 BBR 能使文件传输速度与 API 响应提升数倍!
在 Linux 终端执行以下配置并持久化写入 `/etc/sysctl.conf`:
• `net.core.default_qdisc = fq` —— 将系统默认队列调度算法设置为公平队列(Fair Queuing)
• `net.ipv4.tcp_congestion_control = bbr` —— 启用 BBR 拥塞控制算法
• 执行 `sysctl -p` 验证:若 `sysctl net.ipv4.tcp_congestion_control` 返回 `bbr` 即表示生效成功。
2. 突破 TCP 读写缓冲区与网络套接字限制
默认 Linux 参数往往偏向保守,在高并发长连接场景下极易成为吞吐瓶颈。必须调大套接字缓冲区与连接跟踪表上限:
• 调大最大文件句柄与进程限制:`fs.file-max = 2097152`,并在 `/etc/security/limits.conf` 中为用户设置 `nofile 1048576`。
• 调优 TCP 读写内存上限:`net.ipv4.tcp_rmem = 4096 87380 16777216`,`net.ipv4.tcp_wmem = 4096 65536 16777216`,支持更大滑动窗口。
• 优化连接跟踪上限防止丢包:`net.netfilter.nf_conntrack_max = 1048576`,`net.netfilter.nf_conntrack_tcp_timeout_established = 600`。
3. 高性能存储与 NVMe 本地 SSD 缓存调优
针对数据库或高性能缓存节点,强烈建议在 Compute Engine 实例上挂载【Local SSD(本地 NVMe 固态硬盘)】。Local SSD 直接通过 PCIe 通道与宿主机相连,单盘可轻松提供超 800,000 读写 IOPS 与微秒级极低延迟。配置时务必采用 RAID 0 阵列组合,并将 I/O 调度器调整为 `none` 以消除内核多余调度开销。
四、企业级高可用架构:托管实例组(MIG)、健康检查与 Cloud Armor 纵深防御
单台云服务器即便调优到极致,也存在单点故障风险。出海架构的黄金准则是:‘面向故障而设计(Design for Failure)’。
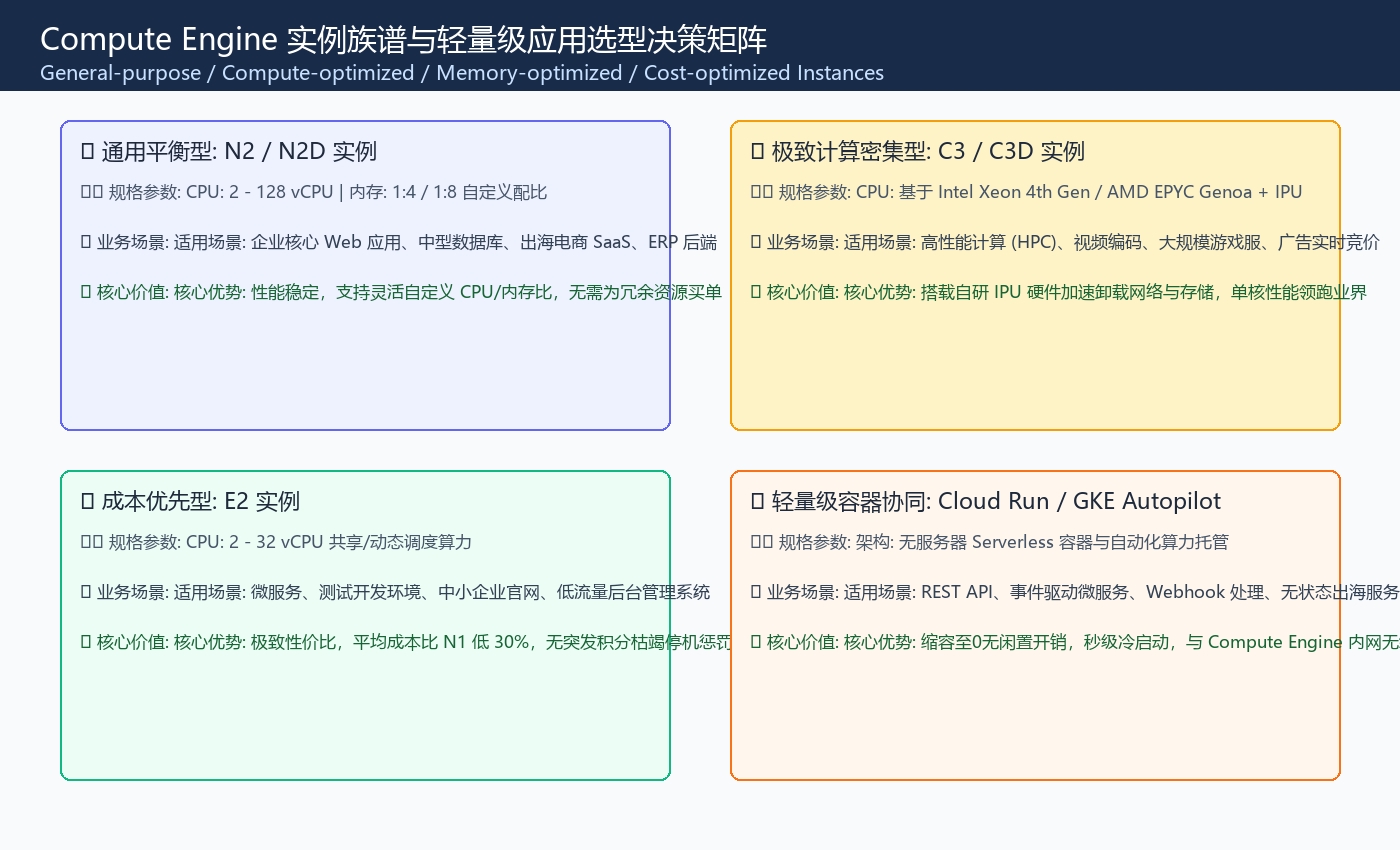
图 2:Compute Engine 托管实例组 (MIG) 与 Cloud Armor 高可用安全防御全景
1. 区域级托管实例组(Regional MIG)与自动自愈
• 多可用区自动分布容灾:创建一个 Regional MIG,系统会自动将虚拟机实例均匀分散在同一地域(Region)下的 3 个独立可用区(Zones)中。当单一可用区发生不可抗力物理故障时,其余可用区实例无缝接管业务。
• 基于应用层健康检查的应用自愈(Auto-healing):配置精准的 HTTP `/healthz` 深度健康检查探针。一旦某台虚机内部的业务进程发生死锁或崩溃连续超时,MIG 会自动将其从负载均衡中剔除并自动销毁重建,实现零人工干预的自动化运维。
• 基于 CPU / 自定义指标的弹性伸缩(Auto-scaling):设定 CPU 目标利用率为 65% 或 QPS 阈值,当海外早高峰流量暴涨时,集群在 1-2 分钟内自动横向扩容实例;夜间低谷期自动缩容,最大化节省闲置算力成本。
2. 纵深安全防御:Cloud Armor 与零信任 IAP
• Cloud Armor 企业级 WAF:位于 Google 全球边缘层,直接在流量到达虚拟机前阻断 Tbps 级别的 L3/L4 DDoS 洪水攻击与针对 Web 应用的 SQL 注入、XSS 跨站脚本等 OWASP Top 10 恶意请求。
• Identity-Aware Proxy (IAP) 零信任内网运维:彻底关闭所有 Compute Engine 虚拟机的公网 22 (SSH) 和 3389 (RDP) 端口!运维团队通过 IAP 隧道结合 Google 企业身份认证安全登录内部虚机,从根本上杜绝黑客扫描爆破公网端口的严重隐患。
五、FinOps 降本组合拳:SUD + CUD + Spot + 代理商专属返利全解析
在海外宏观经济环境与企业精细化运营大背景下,云计算成本治理(FinOps)已经从‘可选项’上升为出海企业的‘核心竞争力’。Google Cloud 提供了业界最丰富、最具弹性的成本优化工具箱。
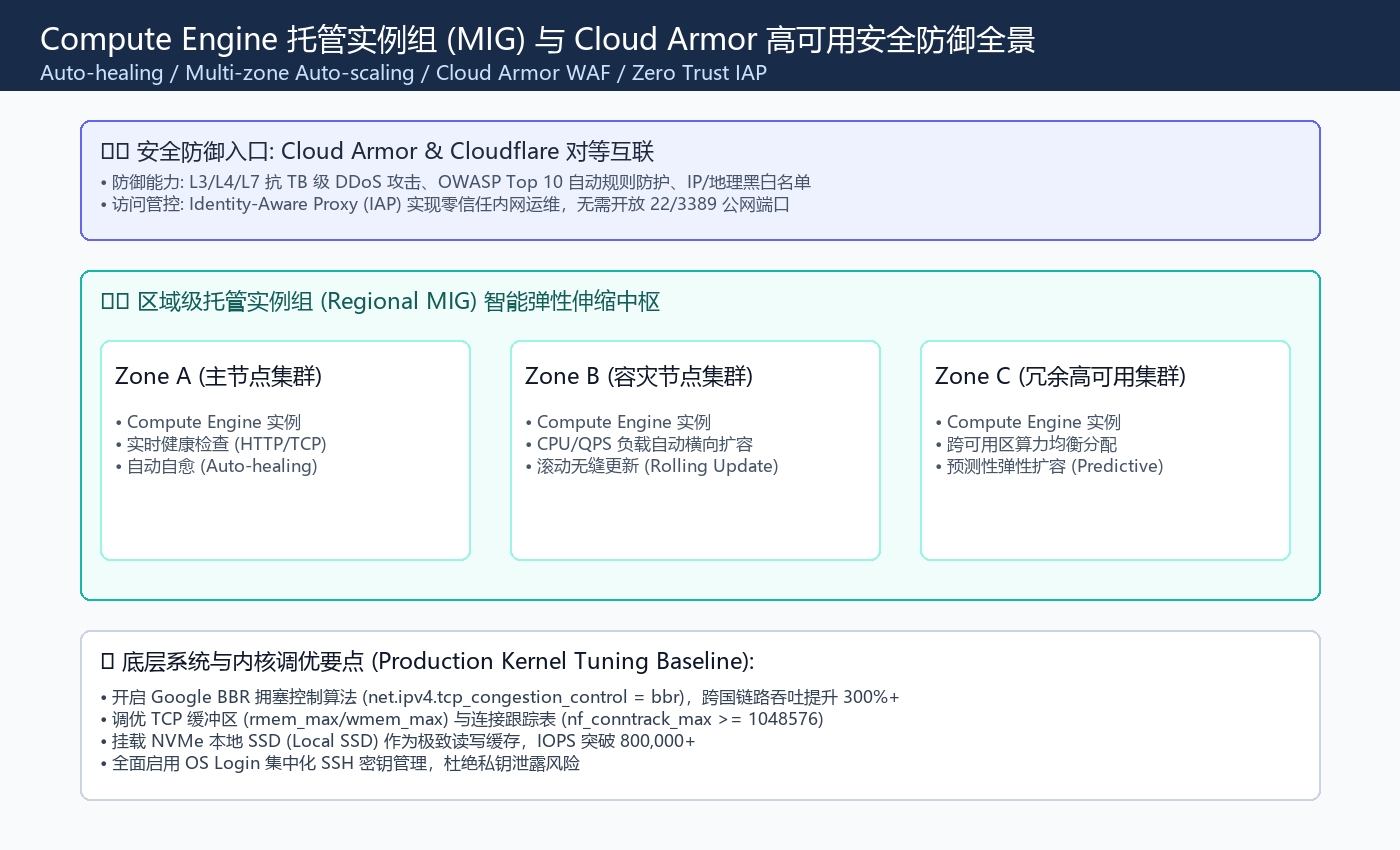
图 3:Google Cloud 企业级立体多维降本模型(FinOps Architecture)
1. 持续使用折扣(Sustained Use Discounts, SUD)
这是 Google Cloud 首创的人性化自动省钱机制:【完全不需要用户提前签订任何 1-3 年长期承诺合同,也不需要提前预付任何定金】!只要某台按量付费的 Compute Engine 实例在当月累计运行时间超过 25%,系统后台就会根据阶梯算法自动应用折扣。当实例全月 100% 运行时,基础计算成本自动减免高达 30%!这非常适合那些业务处于快速变化、无法提前预估未来一年算力规模的敏捷业务。
2. 承诺使用折扣(Committed Use Discounts, CUD)
对于业务已经进入稳定期的生产基线负载,强烈建议配置 CUD:
• 基于资源的 CUD(Resource-based CUD):承诺购买特定 Region 和特定机型族的 vCPU 与内存基线,1 年期折扣约为 37%,3 年期折扣高达 55% 至 70%!
• 灵活资源型 CUD(Flexible CUD):允许在所有机型族、跨全球所有 Region 之间自由切换使用,依然享有高达 46% - 52% 的高额折扣,极大降低了因未来技术架构选型变动带来的锁定风险。
3. 抢占式竞价实例(Spot VMs)
利用 Google 全球数据中心的空闲富余算力,价格低至标准按需价格的 9% 至 40%(即立省 60% 至 91%)。虽然 Google 拥有在资源紧张时提前 30 秒通知回收该实例的权利,但将其用于无状态的离线大数据批处理、AI 模型分布式微调、CI/CD 构建流水线或容错测试集群,能够以极低成本完成海量计算任务。
如果需要更深入咨询了解可以联系全球代理上TG:jinniuge 他们在云平台领域有更专业的知识和建议,他们有国际阿里云,国际腾讯云,国际华为云,aws亚马逊,谷歌云一级代理的渠道,客服1V1服务,支持免实名、免备案、免绑卡。开通即享专属VIP优惠、充值秒到账、官网下单享双重售后支持。不懂找他们就对了。
本文由不代表本站立场,转载联系作者并注明出处。